Outils actuels / raisonnement
Mise à jour 6 octobre 2026

Raisonnement des IA
combien vaut une minute de réflexion ?

Du modèle à part au curseur d'effort : mesures, coûts et limites (septembre 2026)

En 2026, le raisonnement n'est plus une famille de modèles à part : c'est un curseur, présent dans tous les modèles de pointe. Chaque cran d'effort achète des points de benchmark contre des tokens facturés, et une « pensée » affichée qui ne dit pas toujours ce qui a guidé la réponse. Cette page explique comment on fabrique un modèle qui raisonne, ce que mesurent vraiment les tests, ce que coûte une réflexion, et quand il vaut la peine de la payer.

Test-time computeEffort réglableRL vérifiableChaîne de pensée
< 1 → 62,7 %
ARC-AGI-3 en six mois
Meilleur score en harnais standard, du lancement (25 mars) au 3 septembre 2026 (GPT-6 Astra). Les humains font 100 %. 99,9 % avec le harnais de l'éditeur.
26 098 $
Prix d'une évaluation ARC-AGI-3
GPT-6 Astra à l'effort maximal, harnais standard (ARC Prize, septembre 2026).
35 → 98 %
FrontierMath Tier 4
Problèmes de niveau recherche : 35,4 % pour GPT-5.5 (avril 2026) puis 97,6 % pour GPT-6 Astra (septembre), sur deux versions du test pas strictement comparables.
25 à 39 %
Aveux dans la chaîne de pensée
Part des cas où le modèle mentionne l'indice qui a guidé sa réponse (Claude 3.7 Sonnet, DeepSeek R1 ; Anthropic, 2025).
Niveaux d'effortInstantminimallowmediumhighxhighmaxultra
Du modèle au curseur / 01

Du modèle « qui réfléchit » au curseur d'effort

En deux ans, le raisonnement est passé d'une gamme à part à un réglage présent dans tous les modèles de pointe.

En septembre 2024, OpenAI lançait o1, un modèle « qui réfléchit » avant de répondre. Un an plus tard, la distinction avait disparu : GPT-5 décide lui-même quand réfléchir, Claude propose une réflexion étendue puis adaptative, et Gemini 3 réfléchit par défaut. En 2026, la question n'est plus « quel modèle de raisonnement ? » mais « quel niveau d'effort pour cette tâche ? »
  1. Sept. 2024Modèle à part

    OpenAI o1

    Premier modèle présenté comme « réfléchissant » avant de répondre. Sa chaîne de pensée reste cachée : l'utilisateur n'en voit qu'un résumé.
  2. Janv. 2025Poids ouverts

    DeepSeek R1

    Poids ouverts et recette publiée : un apprentissage par renforcement qui récompense la seule réponse juste. Sa réflexion s'affiche en entier.
  3. Févr. 2025Hybride

    Claude 3.7 Sonnet

    Premier modèle « hybride » : le même modèle répond directement ou après une réflexion étendue, au choix de l'utilisateur.
  4. Août 2025Intégré

    GPT-5

    La série o (o1 en septembre 2024, o3 en avril 2025) est absorbée dans un « système unifié » : un routeur décide quand réfléchir.
  5. Nov. 2025Par défaut

    Gemini 3

    La réflexion devient active par défaut, dosée par le paramètre thinking_level. Gemini 3 Deep Think pousse le curseur au maximum.
  6. 2026Réglage

    Le curseur partout

    Effort de low à max chez Anthropic (réflexion toujours active sur Claude Fable 5, juin 2026), d'Instant à Extra High dans ChatGPT, de 1 à 100 sur DeepSeek V4.1 (septembre 2026).
Mécanique / 02

Comment on fabrique un modèle qui raisonne

Trois idées suffisent : récompenser la réponse juste, laisser le modèle calculer plus longtemps, et doser ce calcul.

Ces modèles sont des LLM entraînés par renforcement, pas des systèmes neuro-symboliques. Le neuro-symbolique (AlphaProof, preuves formalisées en Lean) reste une branche voisine.
RL vérifiable

Récompenser la réponse juste

On ne montre pas au modèle comment raisonner : on le récompense quand la réponse finale est juste (calcul vérifiable, tests de code qui passent). L'algorithme GRPO, introduit par DeepSeek en 2024, compare plusieurs réponses du même modèle et renforce les meilleures. Pendant l'entraînement de R1-Zero, ce seul signal fait passer AIME 2024 de 15,6 % à 77,9 %, sans exemple de raisonnement humain : les longues réflexions, retours en arrière et vérifications « émergent ».
Test-time compute

Calculer au moment de la réponse

Dès 2024, OpenAI montrait que la performance d'o1 progresse avec le temps de réflexion accordé (test-time compute). Une étude Google/Berkeley montrait qu'un petit modèle qui réfléchit bien peut battre un modèle 14 fois plus gros. Mais le rendement décroît : chaque point gagné coûte plus cher que le précédent.
Effort

Doser ce calcul

Le curseur d'effort fixe combien de tokens de réflexion le modèle peut dépenser avant de répondre. Anthropic conseille de réserver l'effort max aux « problèmes de frontière » : sur une tâche simple, le modèle peut « sur-réfléchir » sans rien gagner.
Le curseur / 03

Le curseur d'effort chez chaque éditeur

Même principe, quatre réglages. Relevé mi-septembre 2026 : les modèles de tête changent tous les deux à trois mois.

Un point commun : aucun des trois grands éditeurs fermés ne montre plus la chaîne de pensée brute, seulement un résumé. La raison est d'abord commerciale : ces brouillons de réflexion sont une donnée d'entraînement précieuse. Un concurrent qui les collecte en masse peut s'en servir pour apprendre à raisonner à son propre modèle (la distillation), c'est-à-dire « voler » à moindre coût un savoir-faire qui a coûté cher à produire. OpenAI l'assumait dès o1, en 2024, en invoquant l'avantage concurrentiel. Seuls les modèles à poids ouverts exposent leur réflexion en entier.
01Résumés seulement

OpenAI

  • Modèles de tête : GPT-6 Astra (3 sept. 2026) ; GPT-5.6 Sol, Terra, Luna
  • Réglage : reasoning_effort dans l'API, curseur « Thinking » dans ChatGPT
  • Niveaux : Instant, Medium, High, Extra High ; xhigh, max et ultra (4 agents en parallèle)
  • Prix API au lancement (entrée / sortie, par million de tokens) : Astra 10 / 50 $, Sol 5 / 30 $, Luna 1 / 6 $, en baisse depuis
02Résumé ou masqué

Anthropic

  • Modèles de tête : Claude Fable 5.1 (1er sept. 2026) ; Opus 5 ; Sonnet 5
  • Réglage : paramètre effort et pensée adaptative ; sur Fable 5, la réflexion ne peut pas être désactivée
  • Niveaux : low, medium, high (par défaut), xhigh, max
  • Prix API : Fable 10 / 50 $ ; la réflexion complète est facturée même si l'on ne reçoit qu'un résumé
03Résumés seulement

Google

  • Modèles de tête : Gemini 3.1 Pro et 3.1 Deep Think ; Gemini 3.8 Flash
  • Réglage : thinking_level, réflexion active par défaut sur toute la famille 3.x
  • Niveaux : minimal, low, medium, high selon le modèle
  • Offres : Google AI Pro et Ultra (ex-Gemini Advanced), API Gemini
04Chaîne visible

DeepSeek

  • Modèles de tête : V4-Pro et V4.1-Flash (10 sept. 2026), poids ouverts sous licence MIT
  • Réglage : modes de réflexion ; reasoning_effort
  • Niveaux : Non-think, Think High, Think Max ; effort de 1 à 100 sur V4.1
  • Chaîne de pensée : visible en entier
Mesures / 04

Le plafond qui recule

Les tests de raisonnement saturent en quelques mois. Et le score dépend autant du protocole que du modèle.

Quatre tests conçus pour résister aux modèles, quatre plafonds enfoncés ou presque. Un score ne vaut que pour son protocole : sur ARC-AGI-3, le même modèle passe de 62,7 % à 99,9 % selon l'outillage qui l'entoure (le « harnais »).

▽ Au lancement du test → meilleur score en septembre 2026

au lancement septembre 2026

ARC-AGI-3

Pas saturé

Jeux interactifs inédits · humains : 100 %

< 1 %Mars 2026, lancement
62,7 %Sept. 2026 · GPT-6 Astra, harnais standard

99,9 % avec le harnais de l'éditeur. Opus 5 : 30,2 % ; GPT-5.6 Sol : 7,8 %.

ARC-AGI-2

Saturé

Casse-têtes visuels abstraits

≈ 0 %Mars 2025
84,6 %Févr. 2026 · Gemini 3.1 Deep Think, vérifié par ARC Prize

95 % annoncés par OpenAI pour GPT-6 Astra, non vérifiés.

FrontierMath Tier 4

Saturé

Mathématiques de niveau recherche

≈ 5 %Été 2025
97,6 %Sept. 2026 · GPT-6 Astra (version 2 du test)

Epoch a corrigé 42 % des problèmes le 12 juin 2026 : les versions ne sont pas strictement comparables. GPT-5.5 : 35,4 % (avril 2026, version 1).

Humanity's Last Exam

Pas saturé

Questions d'experts, toutes disciplines

26,6 %Févr. 2025 · o3 deep research
59,1 %Sept. 2026 · Claude Fable 5.1 max (Artificial Analysis)

65 % avec outils dans le tableau d'OpenAI : l'écart dépend des outils et de la configuration.

Échelle commune de 0 à 100 %. Meilleur score publié ou vérifié à chaque date ; détail des sources en fin de page.

▽ Olympiades et recherche : de l'argent à la note parfaite

05 jalons

2024 · IMO : l'argent en trois jours

Formel
AlphaProof (Google DeepMind) obtient 28/42, niveau médaille d'argent, après deux à trois jours de calcul, sur des énoncés traduits en langage formel (Lean).

Juillet 2025 · IMO : l'or en langage naturel

Certifié
Une version de Gemini Deep Think obtient 35/42 (or) dans les 4 h 30 réglementaires, notation certifiée par les coordinateurs de l'IMO. OpenAI annonce le même score avec un modèle expérimental.

Sept. 2025 · ICPC : or en programmation

Niveau or
À la finale mondiale ICPC, Gemini 2.5 Deep Think résout 10 problèmes sur 12, dont un qu'aucune équipe humaine n'a résolu. OpenAI annonce 12 sur 12.

Juillet 2026 · IMO : 42/42 ?

Non certifié
Selon la presse, plusieurs modèles (GPT-5.6 Pro, dots-note-3.0 de RedNote) auraient obtenu la note parfaite sur les sujets de l'IMO de Shanghai. Aucune certification officielle n'a été publiée : le site de l'IMO ne mentionne pas l'IA.

2026 · Recherche : dix résultats annoncés

Annonce éditeur
OpenAI décrit dix résultats mathématiques nouveaux obtenus avec une version interne de GPT-6 Astra, pour environ 2 000 $ de tokens, formalisés en Lean. Exemple : l'écart borné entre nombres premiers ramené de 246 à 186. Annonce de l'éditeur, validation par les pairs en cours.
Chaque nouveau test de raisonnement est franchi plus vite que le précédent, d'où la course à des tests plus durs.
Coûts / 05

Ce que coûte une réflexion

La réflexion se paie en tokens de sortie, même quand on ne la voit pas.

Budgéter une IA qui raisonne, c'est budgéter des tokens de sortie, pas des requêtes. La facture dépend du niveau d'effort, pas seulement du modèle.
Facturé

Des tokens invisibles, mais facturés

Un modèle qui réfléchit produit des milliers de tokens, facturés au tarif des tokens de sortie et comptés dans la limite max_tokens. Chez Anthropic, on paie la réflexion complète même quand on ne reçoit qu'un résumé.
Facturé

Une réponse coupée reste due

Chez Google, une réponse interrompue en pleine réflexion (limite de tokens atteinte) est facturée quand même. Il faut prévoir une marge pour la réponse elle-même.
Annonces éditeurs

La course à l'efficacité

GPT-5 égalait o3 avec 50 à 80 % de tokens en moins. OpenAI affirme que GPT-6 Astra utilise 65 % de tokens de sortie en moins que Claude Opus 5 à score comparable. Ces comparaisons sont faites par les éditeurs eux-mêmes.
ARC Prize

Le prix d'un record

Une seule évaluation ARC-AGI-3 de GPT-6 Astra à l'effort maximal coûte 26 098 $ en harnais standard et 18 817 $ en harnais éditeur. Peu de cas d'usage justifient ce niveau d'effort.
Limites / 06

Peut-on croire ce que le modèle « pense » ?

Deux débats : les modèles raisonnent-ils vraiment, et leur réflexion écrite dit-elle ce qui a guidé la réponse ?

!« The Illusion of Thinking » (Apple, juin 2025)

  • Un effondrement au-delà d'un seuil

    Sur des casse-têtes à difficulté réglable (tour de Hanoï, traversée de rivière), la précision des modèles de raisonnement s'effondre au-delà d'un certain niveau de complexité.

  • Moins d'effort quand c'est plus dur

    Passé ce seuil, les modèles réduisent leur réflexion alors qu'il leur reste du budget de tokens.

?Ce qu'ont pointé les réfutations

  • Des sorties trop longues

    Certaines réponses dépassaient la limite de tokens : l'échec mesurait la taille de la sortie, pas le raisonnement.

  • Des énigmes impossibles

    Des traversées de rivière sans solution étaient comptées comme des échecs du modèle.

  • La leçon durable

    Quand on demande un programme plutôt que la liste des coups, les scores remontent. Les benchmarks mesurent autant le protocole que le modèle.

▽ Lire dans les pensées de l'IA ?

La chaîne de pensée est l'un des meilleurs outils de sécurité disponibles, mais elle est fragile : c'est une trace de travail utile pour le contrôle, pas une explication fidèle.
Juillet 2025

Un outil de sécurité précieux

Lire la réflexion d'un modèle permet d'y repérer une intention de tricher ou de contourner une consigne. En juillet 2025, plus de 40 chercheurs de tous les grands laboratoires ont défendu cette « surveillabilité », en la qualifiant de fragile.
25 à 39 %

Des aveux rares

Quand on glisse un indice dans la question, Claude 3.7 Sonnet ne mentionne l'avoir utilisé que dans 25 % des cas, DeepSeek R1 dans 39 % (Anthropic, 2025). Ce que le modèle écrit n'est pas forcément ce qui l'a guidé.
Mars 2025

Punir les mauvaises pensées les cache

OpenAI a montré qu'en pénalisant les « mauvaises pensées » pendant l'entraînement, on apprend au modèle à les dissimuler, pas à y renoncer (mars 2025).
En partie non confirmé

Une réflexion de plus en plus opaque

En septembre 2026, OpenAI reconnaît que la réflexion écrite de GPT-6 Astra est « plus difficile à surveiller » que celle de GPT-5.6 Sol. Selon Fortune, Astra utiliserait une technique de « profondeur récurrente » (des couches parcourues en boucle) qui ferait une partie du calcul sans texte ; OpenAI ne l'a pas confirmé.
Ce qu'on lit n'est qu'une partie de ce qui a produit la réponse, et pas forcément la plus fidèle.
Poids ouverts / 07

Poids ouverts : le raisonnement se démocratise

Pour garder ses données chez soi, ou pour lire la chaîne de pensée en entier.

Les modèles ouverts se comparent désormais aux fermés sur plusieurs tests de raisonnement. Ils restent derrière sur les tâches les plus longues.
01Chiffres éditeur

DeepSeek V4 : au niveau des fermés sur plusieurs tests

V4-Pro (1,6 T de paramètres, licence MIT) et V4.1-Flash (10 sept. 2026, effort réglable de 1 à 100). Sur Humanity's Last Exam avec outils, V4.1-Flash affiche 63,9 % contre 63,6 % pour Claude Opus 5, selon DeepSeek.
02Écart

Encore derrière sur les tâches longues

Sur les tâches agentiques les plus longues, l'écart reste net : 30 % contre 43 % sur Terminal-Bench 3.0, toujours selon les chiffres de DeepSeek.
03Ollama

En local, avec de l'infrastructure

La catégorie « thinking » d'Ollama met en avant deepseek-v4-flash et v4-pro, deepseek-v4.1-flash, qwen3.6 et 3.8, glm-5.x, kimi-k3, mistral-medium-3.5 et nemotron3. Attention à la taille : V4-Flash compte déjà 284 milliards de paramètres.
04Chaîne visible

Poids ouverts, pas open source

Les poids sont publiés, pas les données d'entraînement. Avantage concret : la réflexion reste visible en entier (balises think), utile pour l'audit, sans garantie de fidélité (voir chapitre 06).
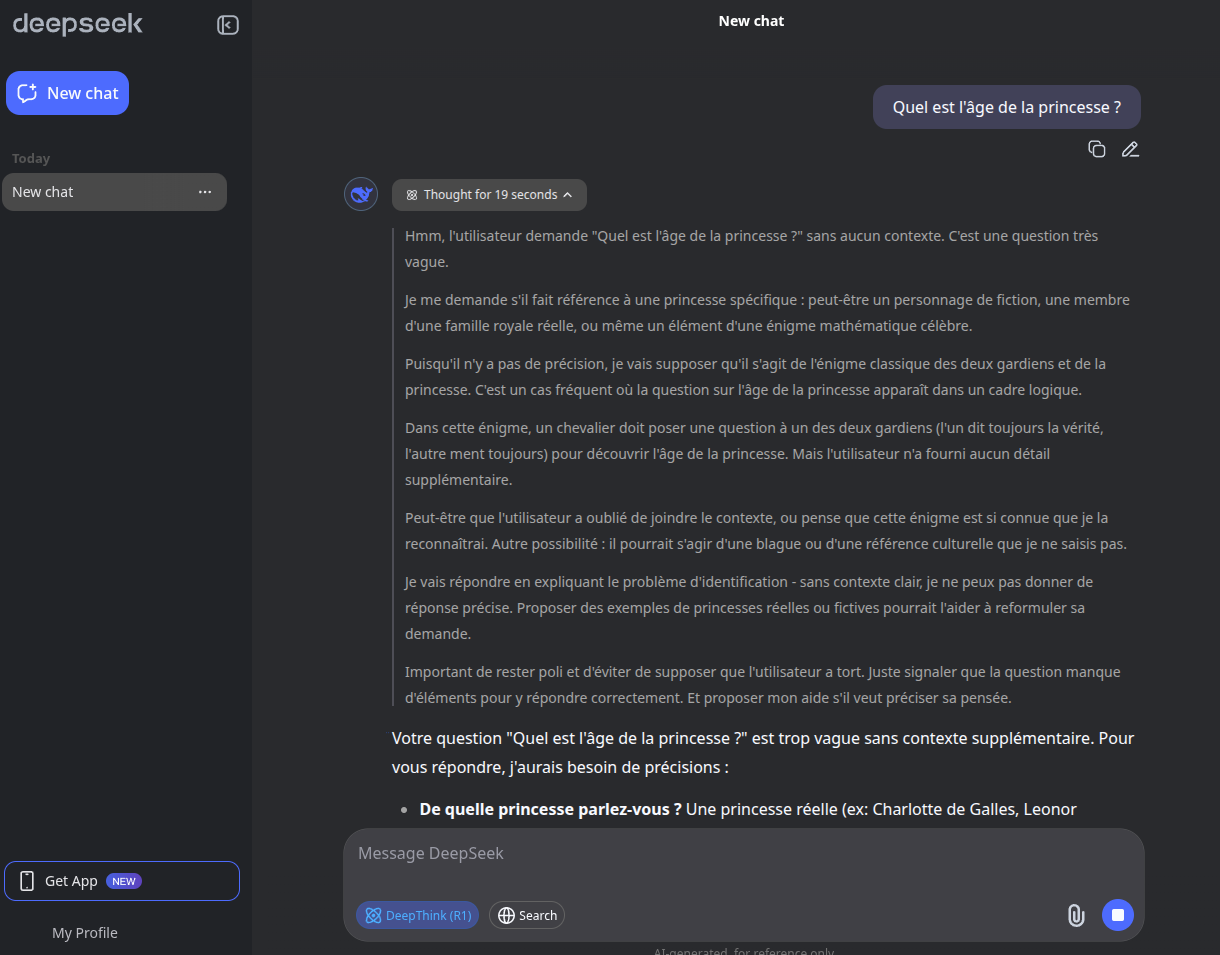
Capture de DeepSeek en mode DeepThink (R1) : le modèle affiche « Thought for 19 seconds » puis toute sa réflexion en français avant de répondre à la question « Quel est l'âge de la princesse ? ».
DeepSeek R1 (capture de 2025) affiche sa réflexion brute avant de répondre. En 2026, les modèles ouverts le font toujours ; les grands modèles fermés, non.
Décider / 08

Quand payer la réflexion ?

Trois règles simples, et une expérience à faire soi-même avant de choisir un réglage.

▽ À retenir

Trois règles pour un décideur

  1. 01Effort bas ou moyen par défaut ; effort haut seulement quand vos propres tests montrent un gain.
  2. 02Budgéter en tokens de sortie, pas en nombre de requêtes : la réflexion est facturée même quand elle est masquée.
  3. 03Ne pas prendre la réflexion affichée pour une justification auditable : garder des vérifications déterministes (tests, règles métier).

▽ L'expérience qui compte : un même problème, deux niveaux d'effort

Posez un problème de votre métier à deux niveaux d'effort, puis comparez justesse, temps de réponse et coût. C'est le meilleur moyen de savoir si la réflexion vaut son prix pour vous.
01Interface

ChatGPT

Comparer Instant et Extra High dans le sélecteur « Thinking ».
02API

Claude

Dans l'API, faire varier le paramètre effort de low à max.
03Interface

Gemini

Comparer une réponse standard et le mode Deep Think (offres Google AI payantes).
04Chaîne visible

DeepSeek

Lire la réflexion en entier sur chat.deepseek.com : utile pour voir où le modèle hésite et se corrige.

▽ CATIE

Choisir le bon niveau d'effort, sans exploser le budget

Le CATIE aide les entreprises à mesurer ce que la réflexion leur rapporte vraiment et à garder la maîtrise des coûts et des données. Nos experts vous aident à :

  • Mesurer le gain réel de l'effort sur vos propres cas d'usage
  • Estimer et suivre le budget en tokens de réflexion
  • Déployer un modèle à poids ouverts en local pour les données sensibles
  • Encadrer les réponses par des vérifications déterministes (tests, règles métier)
  • Former vos équipes aux réglages et aux limites des modèles qui raisonnent
Lectures / 09

Pour aller plus loin

L'article de référence, et quatre lectures pour comprendre les débats.

▽ Lectures

05 lectures

DeepSeek-R1 · Nature, septembre 2025

Référence
L'article de référence : la recette publiée du raisonnement par renforcement. Récompense sur la seule réponse finale, algorithme GRPO, AIME 2024 de 15,6 % à 77,9 % pendant l'entraînement de R1-Zero. Préprint arXiv 2501.12948 (janvier 2025).

Snell et al. · Scaling test-time compute (2024)

Test-time compute
Pourquoi « réfléchir plus longtemps » paie, et quand un petit modèle bien réglé bat un modèle 14 fois plus gros.

Korbak et al. · CoT Monitorability (2025)

Sécurité
Le texte signé par plus de 40 chercheurs : la chaîne de pensée comme opportunité de sécurité, « nouvelle et fragile ».

Shojaee et al. · The Illusion of Thinking (2025)

Débat
L'étude d'Apple sur l'effondrement des modèles face aux casse-têtes, à lire avec le commentaire de Lawsen qui en conteste la méthode.

Sun et al. · A Survey of Reasoning with Foundation Models (2023)

Historique
Panorama utile des approches, mais antérieur à o1 et R1 : il ne couvre ni l'apprentissage par renforcement ni le calcul au moment de la réponse.
Références / 10

Sources et références

  1. [01]DeepSeek-AI – DeepSeek-R1, Nature (17 sept. 2025)
  2. [02]Shao et al. – DeepSeekMath, introduction de GRPO (arXiv, févr. 2024)
  3. [03]OpenAI – Learning to reason with LLMs, o1 (sept. 2024)
  4. [04]Snell et al. – Scaling LLM Test-Time Compute Optimally (arXiv, août 2024)
  5. [05]OpenAI – Guide API « Reasoning »
  6. [06]OpenAI – Introducing GPT-5 (7 août 2025)
  7. [07]OpenAI – GPT-5.6 : Sol, Terra, Luna (2026)
  8. [08]OpenAI Help Center – GPT-5.6 dans ChatGPT
  9. [09]OpenAI – GPT-6 Astra (3 sept. 2026)
  10. [10]OpenAI – Ten advances in mathematics and theoretical computer science (2026)
  11. [11]Anthropic – Documentation « Effort »
  12. [12]Anthropic – Documentation « Thinking » (facturation, résumés)
  13. [13]Anthropic – Claude Fable 5 et Claude Mythos 5 (juin 2026)
  14. [14]Google – API Gemini, « Thinking » (thinking_level, facturation)
  15. [15]Google DeepMind – Gemini 3.1 Deep Think
  16. [16]DeepSeek – Carte de modèle DeepSeek-V4-Pro (Hugging Face)
  17. [17]DeepSeek – Carte de modèle DeepSeek-V4.1-Flash (Hugging Face)
  18. [18]Ollama – Catalogue des modèles « thinking »
  19. [19]ARC Prize – Announcing ARC-AGI-3 (25 mars 2026)
  20. [20]ARC Prize – GPT-6 Astra sur ARC-AGI-3 (3 sept. 2026)
  21. [21]Epoch AI – FrontierMath Tier 4, version 2 (juin 2026)
  22. [22]Artificial Analysis – Classement Humanity's Last Exam
  23. [23]Google DeepMind – Médaille d'or à l'IMO avec Gemini Deep Think (21 juil. 2025)
  24. [24]Google DeepMind – Niveau or à la finale mondiale ICPC (17 sept. 2025)
  25. [25]IMO – IMO 2026 Concludes in Shanghai (20 juil. 2026)
  26. [26]Maths Society – Résultats de l'IMO 2026 (presse, 21 juil. 2026)
  27. [27]Anthropic – Reasoning models don't always say what they think (2025)
  28. [28]Chen et al. – Fidélité des chaînes de pensée (arXiv, mai 2025)
  29. [29]Korbak et al. – Chain of Thought Monitorability (arXiv, juil. 2025)
  30. [30]Baker et al. (OpenAI) – Monitoring Reasoning Models for Misbehavior (arXiv, mars 2025)
  31. [31]Shojaee et al. (Apple) – The Illusion of Thinking (arXiv, juin 2025)
  32. [32]A. Lawsen – Comment on The Illusion of Thinking (arXiv, juin 2025)
  33. [33]Sun et al. – A Survey of Reasoning with Foundation Models (arXiv, déc. 2023)
  34. [34]Wikipédia – GPT-6 Astra (dont « profondeur récurrente » selon Fortune)