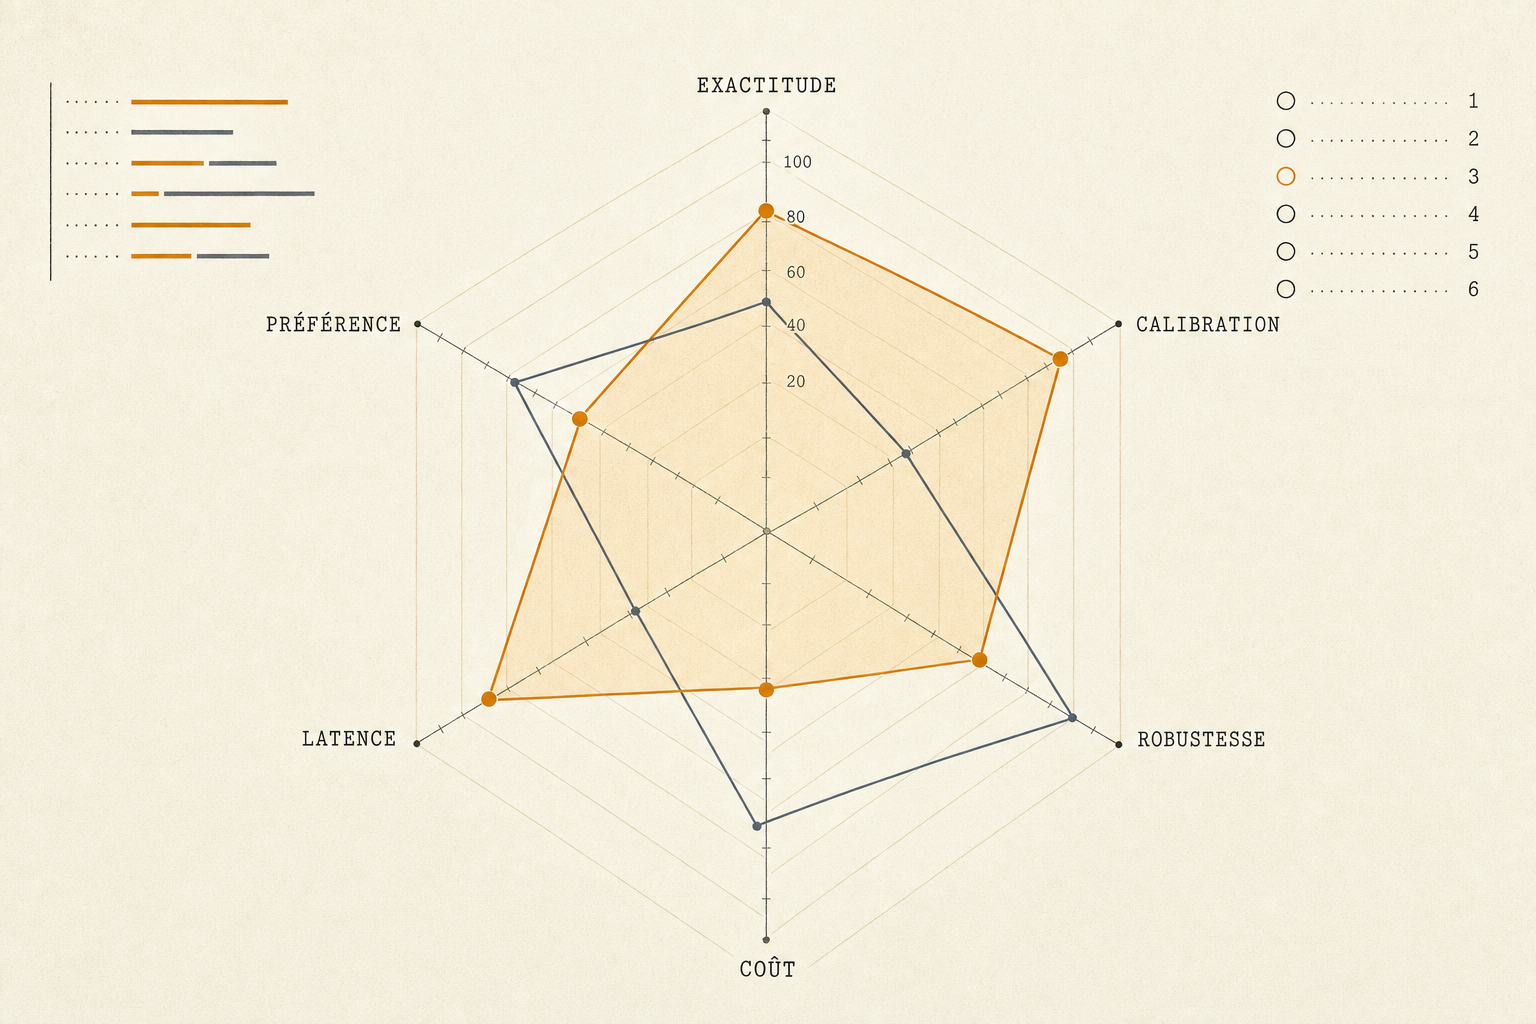
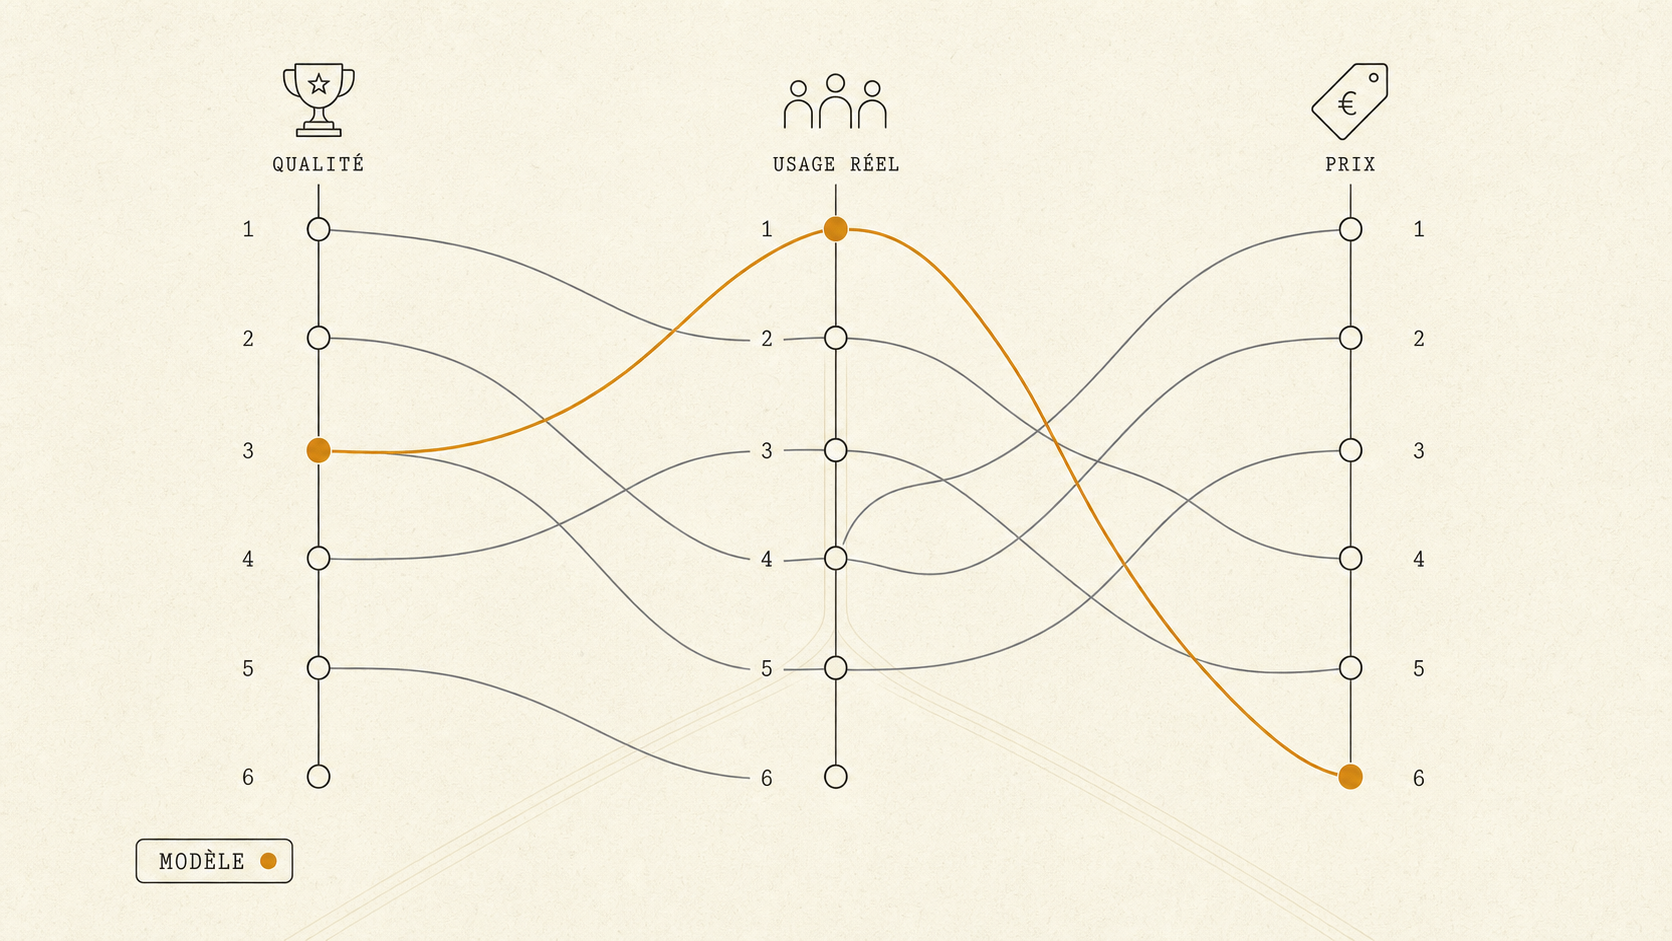
Si l'on devait résumer la période 2024-2026 en une phrase : les benchmarks utiles sont devenus moins des « examens finaux » que des batteries diagnostiques. Les meilleurs rapports d'évaluation ne montrent plus seulement « qui gagne », mais sur quoi le modèle gagne, à quel coût, dans quelles conditions, avec quelle robustesse, et avec quel risque de tromperie méthodologique.
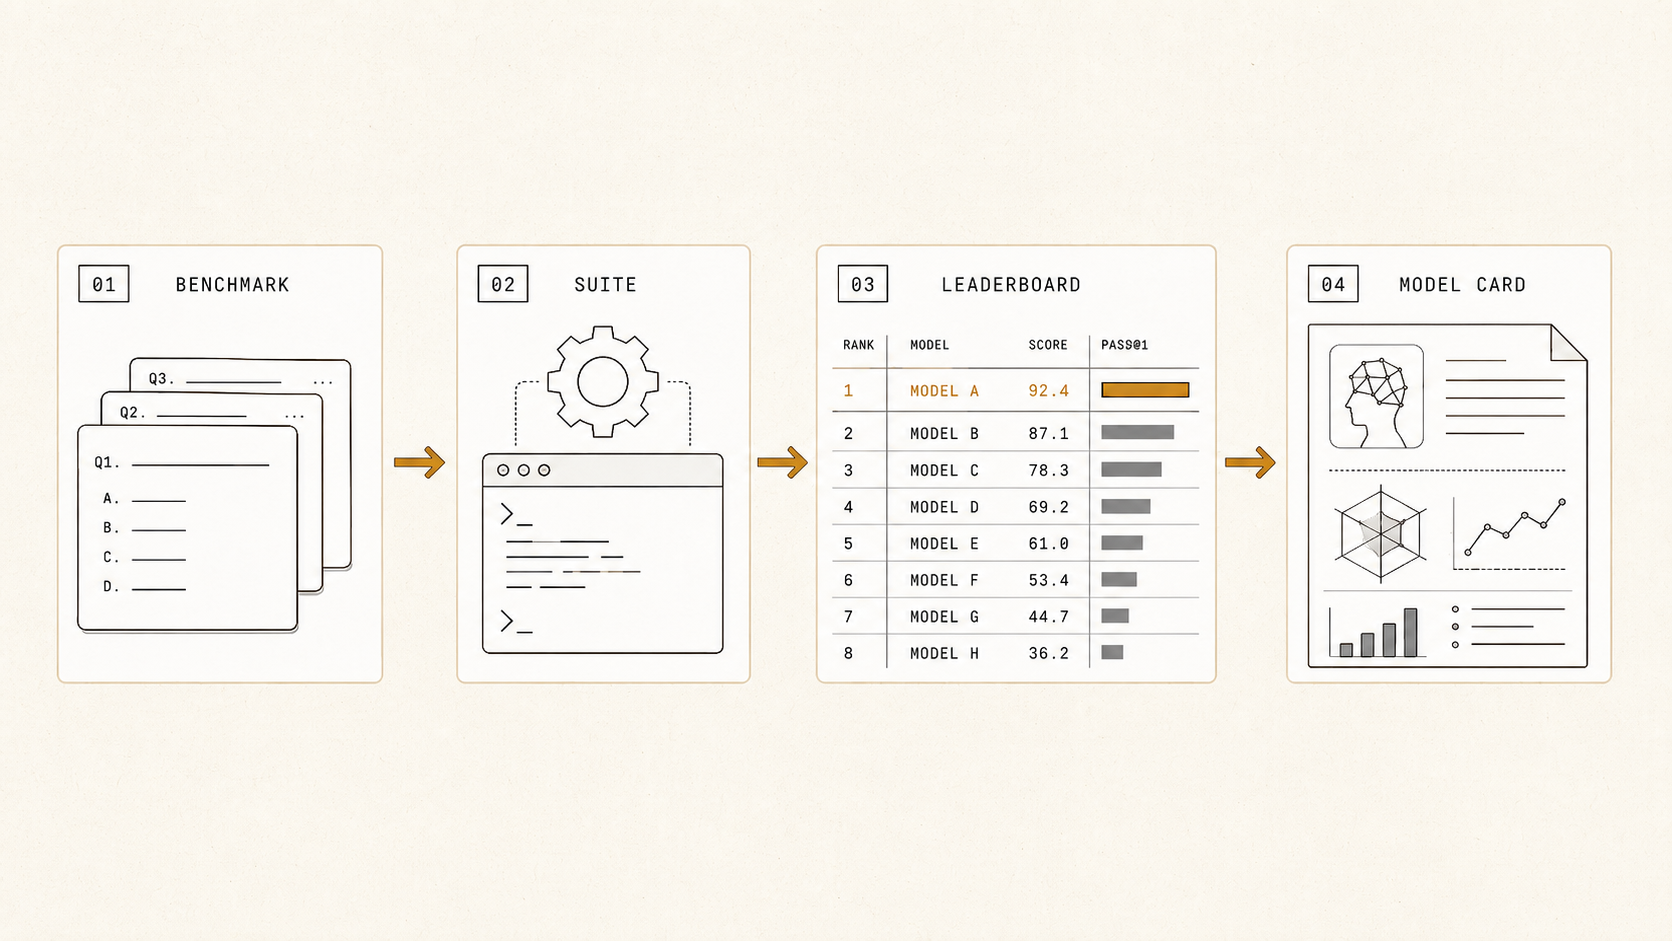
C'est précisément la direction prise par HELM, LiveBench, BFCL, les suites de long contexte, les benchmarks agents récents et les analyses de contamination/leaderboards. Les system cards des fournisseurs reflètent ce changement : la page GPT-4.1 d'OpenAI cite explicitement OpenAI-MRCR, Graphwalks, MMMU, MathVista, CharXiv, ComplexFuncBench et τ-bench, avec des chiffres précis par sous-capacité plutôt qu'un score unique.
Un benchmark qui servait encore de référence en 2023-2024 peut être en 2026 soit saturé (BBH), soit corrigé (MMLU-Redux), soit décontaminé (MMLU-CF), soit déclassé par un successeur plus difficile (BBEH, SWE-bench Pro). Construire une comparaison crédible, c'est désormais combiner plusieurs angles — et accepter qu'aucun score unique ne raconte toute l'histoire.
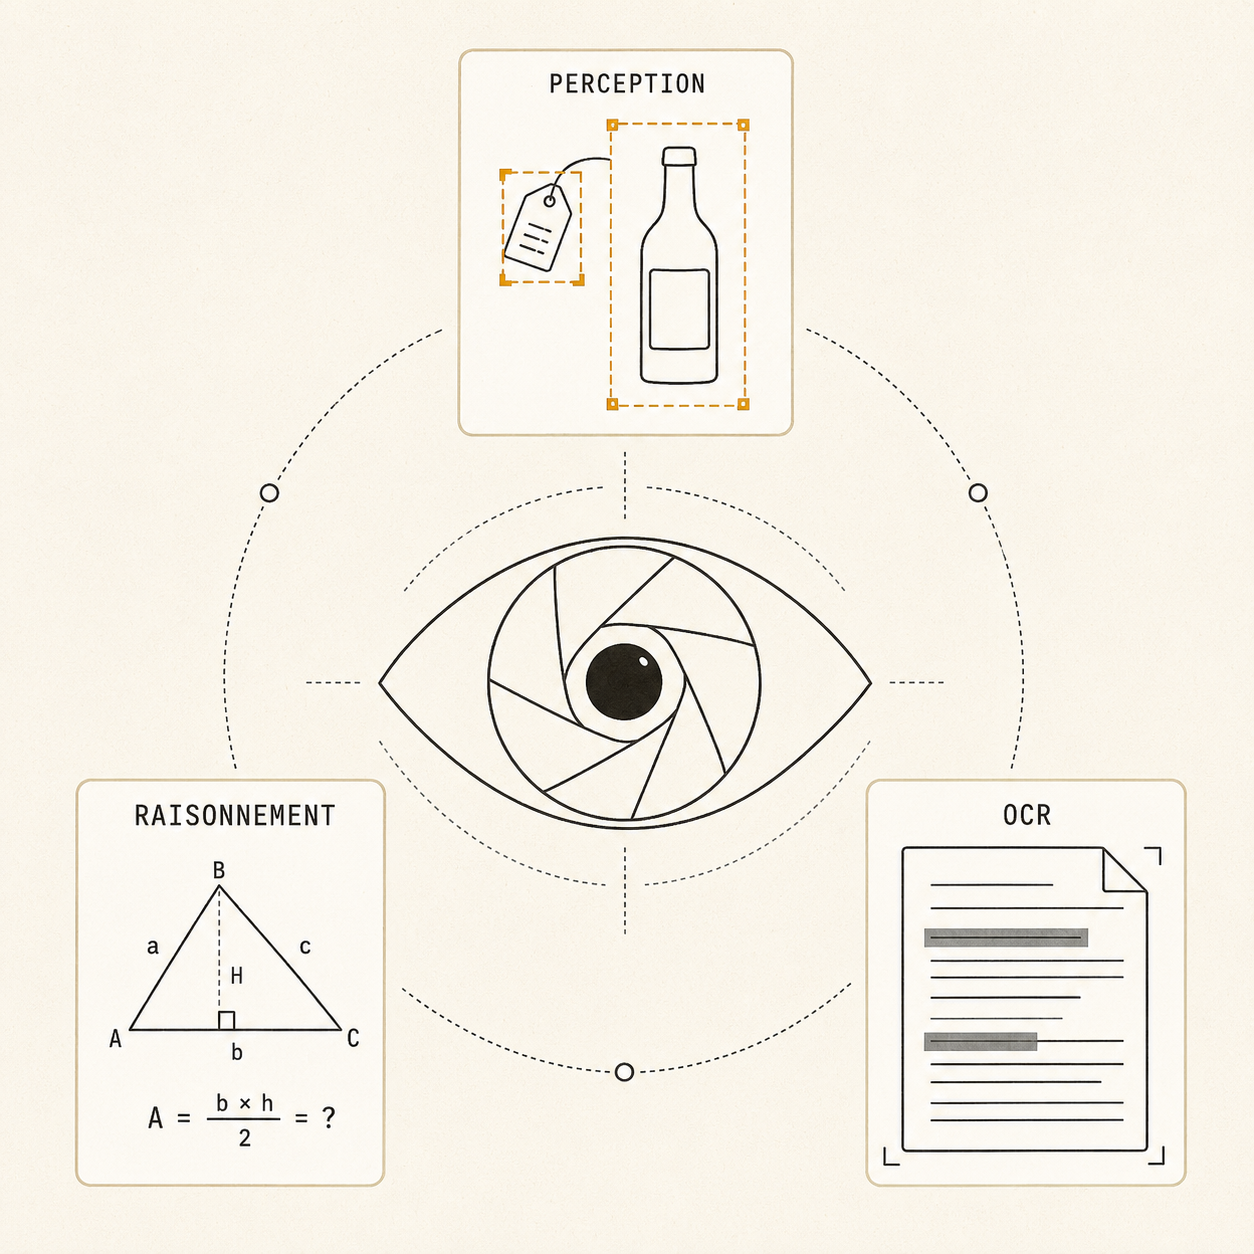
Le principe pratique à retenir : choisir d'abord l'usage visé (connaissance, code, doc, image, vidéo, agent), puis combiner un benchmark stable, un benchmark récent et difficile, et un test réaliste — en documentant scrupuleusement le protocole. C'est la seule manière d'éviter à la fois la saturation, la contamination et le benchmark gaming.