Enjeux techniques et humains de l'IA

Accueil/Outils Actuels/VLA — Vision-Language-Action : les modèles d'action robotique

VLA — Vision-Language-Action : les modèles d'action robotique

Quand un modèle voit, comprend une instruction et commande directement les moteurs d'un robot

Les modèles Vision-Language-Action (VLA) sont la transposition des grands modèles de fondation au monde physique : à partir d'un flux caméra et d'une instruction en langage naturel, ils produisent directement des commandes motrices pour un robot. Apparu en 2023 avec RT-2 de Google DeepMind, le paradigme a explosé. En juin 2026, presque chaque grand laboratoire d'IA possède son modèle de fondation robotique, et des startups très financées — Physical Intelligence (π0 / π0.5), Figure (Helix) — courent pour devenir « l'OpenAI du physique ». Cette page situe les fondations historiques, l'état de l'art 2026 (Gemini Robotics, NVIDIA GR00T, MolmoAct, SmolVLA), les défis techniques (latence temps-réel, action chunking, exécution embarquée) et les limites encore profondes.
Robotique fondamentale
Cross-embodiment
Flow matching
Action chunking
Inférence embarquée
Humanoïdes
Manipulation
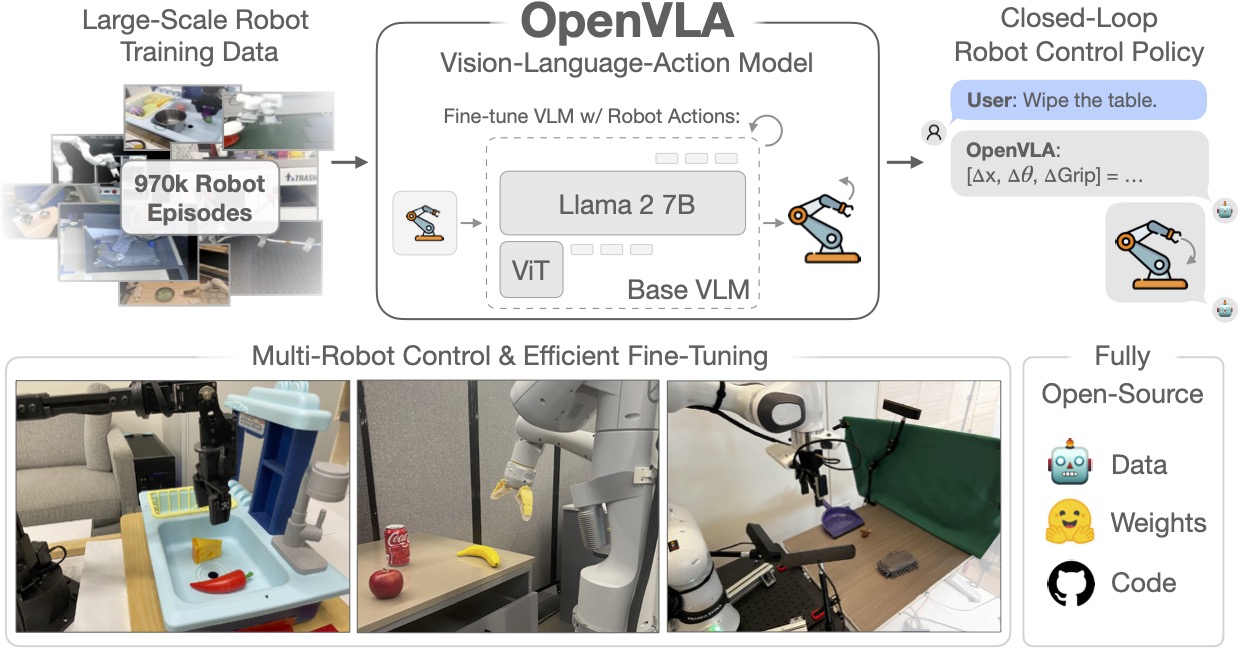
OpenVLA — modèle Vision-Language-Action pour le contrôle robotique en boucle fermée
Qu'est-ce qu'un modèle Vision-Language-Action ?
Un VLA fait trois choses en une seule passe : il voit (flux caméra), il comprend (instruction en langage naturel), et il agit (il émet des commandes motrices). Entrée : pixels + texte ; sortie : actions du robot.
Contrairement à un VLM (Vision-Language Model) classique qui produit du texte, un VLA produit des actions — positions articulaires, déplacements de l'effecteur, ouverture de pince — exécutées à haute fréquence pour piloter un corps réel.
Le VLA hérite de la sémantique « bon sens » apprise sur les données internet par son backbone vision-langage : il sait ce qu'est une « tasse », une « éponge » ou « ranger », et peut généraliser à des objets jamais vus en démonstration.
L'apprentissage repose sur l'imitation : des milliers d'heures de démonstrations (téléopération, vidéos humaines, données simulées) où le robot apprend à associer perception + consigne à la bonne trajectoire d'actions.
L'avancée majeure récente est le cross-embodiment : entraîner un seul modèle sur les démonstrations de plusieurs corps de robots différents, ce qui améliore les performances sur chaque corps individuellement par rapport à un modèle dédié.
C'est le pont entre l'IA générative et la robotique : le même type d'architecture transformeur qui génère du texte génère désormais des plans d'action moteurs dans le monde physique (« physical AI » / « embodied AI »).

Trois générations : des fondations 2022-2024 à l'état de l'art 2026

Génération fondatrice (2022-2024) : RT-1, RT-2, PaLM-E, OpenVLA
RT-1 (Google, 2022) : politique transformeur entraînée sur ~130 000 démonstrations d'un seul robot, sortant des tokens d'action. RT-2 (Google DeepMind, mi-2023) établit le paradigme VLA en greffant un backbone vision-langage pré-entraîné (PaLM-E, PaLI-X) — le robot hérite du « bon sens » d'internet. OpenVLA (2024), 7 milliards de paramètres open-source (Llama 2 + Prismatic), entraîné sur Open X-Embodiment, démocratise la recherche.
Avantages
Preuve de concept du transfert de la sémantique web vers l'action ; premiers modèles cross-embodiment ; ouverture (OpenVLA)
Limitations
Actions discrétisées en tokens (mouvements saccadés), généralisation limitée, peu déployables hors laboratoire
Perspective
Socle conceptuel : le VLA comme « VLM qui émet des actions »
Génération flow matching (2024-2025) : π0, π0.5, SmolVLA
π0 de Physical Intelligence (oct. 2024) remplace la discrétisation par le flow matching, un procédé proche de la diffusion qui génère des trajectoires continues et fluides, bien meilleur sur les tâches de contact (plier du linge). π0.5 (avril 2025) ajoute la généralisation « open world » : il nettoie des cuisines de maisons jamais vues, sur des tâches de 10 à 15 minutes. SmolVLA (Hugging Face, 2025) montre qu'un modèle de 450 M de paramètres suffit pour tourner sur un simple GPU grand public.
Avantages
Mouvements continus et naturels, généralisation à de nouveaux environnements, modèles compacts viables
Limitations
Toujours dépendant d'énormes volumes de démonstrations, robustesse encore fragile hors distribution
Perspective
Le VLA devient déployable hors labo et accessible à la communauté
Génération industrielle (2025-2026) : Gemini Robotics, GR00T, Helix, MolmoAct
Gemini Robotics On-Device (Google DeepMind, 2025) optimise un VLA pour tourner localement sur le robot, sans réseau. NVIDIA Isaac GR00T N1 (mars 2025) est le premier modèle de fondation ouvert pour humanoïdes. Figure Helix (2025) introduit une architecture à deux systèmes (réflexe rapide 200 Hz + raisonnement lent). MolmoAct d'Ai2 (2025) raisonne en 3D via des tokens de perception de profondeur. La course est lancée entre laboratoires et startups.
Avantages
Exécution embarquée temps-réel, humanoïdes généralistes, raisonnement spatial 3D, écosystèmes industriels (Isaac, SDK)
Limitations
Coût matériel élevé, sécurité non résolue, généralisation toujours partielle, données rares
Perspective
Passage du démonstrateur de recherche au produit déployé sur des robots réels
Les modèles VLA de référence en juin 2026
Acteurs vérifiés, leurs architectures et leur mode d'accès. Spécifications issues des annonces officielles et publications.
Startups spécialisées « physical AI »
Physical Intelligence π0 / π0.5
VLA flow matching généraliste
π0 (~3 Md params) génère des trajectoires continues par flow matching. π0.5 (avril 2025) généralise à des maisons jamais vues : nettoyage de cuisines et chambres, tâches de 10-15 min. Entraîné sur ~400 h de manipulation mobile + données multi-robots.
Recherche / poids partagés (openpi)
Voir Physical Intelligence π0 / π0.5
Figure Helix
VLA humanoïde deux systèmes
Architecture double : System 2 (VLM 7 Md, 7-9 Hz) pour la sémantique, System 1 (politique visuo-motrice 80 M, 200 Hz) pour le contrôle réflexe. Contrôle du haut du corps (poignets, torse, tête, doigts) ; premier VLA pilotant deux robots sur une tâche partagée.
Propriétaire (robots Figure)
Voir Figure Helix
Grands laboratoires
Google DeepMind Gemini Robotics
VLA + raisonnement (ER)
Famille de modèles robotiques fondés sur Gemini. Gemini Robotics-ER (Embodied Reasoning) pour le raisonnement spatial et la planification. Gemini Robotics On-Device tourne localement (robustesse hors réseau, latence) et s'adapte avec 50 à 100 démonstrations ; SDK + simulateur MuJoCo fournis.
API Gemini (Robotics-ER) / SDK
Voir Google DeepMind Gemini Robotics
NVIDIA Isaac GR00T N1 / N1.7
Fondation ouverte humanoïdes
Premier modèle de fondation ouvert pour humanoïdes. Architecture à double système (action rapide + planification lente). Entraîné sur vidéos humaines égocentriques, trajectoires réelles/simulées et données synthétiques. Checkpoint GR00T-N1-2B, données et benchmarks publics ; testé sur Fourier GR-1 et 1X.
Open weights (licence permissive)
Voir NVIDIA Isaac GR00T N1 / N1.7
Ai2 MolmoAct
Action Reasoning Model (3D)
« Action Reasoning Model » bâti sur le LLM Molmo (~7 Md). Raisonne en 3D via des tokens de perception de profondeur. 72,1 % de réussite sur tâches hors-distribution (SimplerEnv) en surpassant des modèles concurrents, avec un entraînement nettement plus sobre. Code, scripts et dataset post-entraînement ouverts.
Open-source (code + dataset)
Voir Ai2 MolmoAct
Modèles compacts et communautaires
Hugging Face SmolVLA
VLA compact (450 M)
VLA de 450 M de paramètres tournant sur CPU, un seul GPU grand public, voire un MacBook. Backbone vision-langage compact + tête flow-matching. Pré-entraîné sur ~10 M de frames issues de 487 datasets communautaires « lerobot ». Référence de l'accessibilité robotique.
Open-source (LeRobot)
Voir Hugging Face SmolVLA
OpenVLA (7B)
Fondation open-source (2024)
Modèle 7 Md ouvert (Prismatic VLM + Llama 2) entraîné sur Open X-Embodiment. Plus compact que RT-2 mais le surpasse sur une suite de tâches de manipulation. Pilier de la recherche académique et base de nombreux dérivés.
Open-source
Voir OpenVLA (7B)
Open X-Embodiment
Dataset cross-embodiment
Jeu de données collaboratif agrégeant des démonstrations de dizaines de corps de robots différents. Socle de l'apprentissage cross-embodiment qui permet d'entraîner un modèle unique généralisant mieux que les politiques spécifiques à un robot.
Open dataset
Voir Open X-Embodiment

Plongée technique : architecture, action chunking et latence temps-réel

Pourquoi piloter un corps en temps réel est radicalement plus dur que générer du texte

Un VLA n'est pas qu'un « LLM avec des bras ». Le passage du langage à l'action impose des contraintes physiques dures : le robot vit dans un monde continu, en temps réel, où une décision arrivant 200 ms trop tard fait échouer la tâche — ou casse quelque chose. Trois grands choix d'ingénierie structurent les modèles de 2026.

1. De la perception à l'action : tokens discrets vs flow matching

Les premiers VLA (RT-2, OpenVLA) discrétisaient les actions en tokens, exactement comme un LLM prédit des mots : l'espace continu des commandes (positions, vitesses) était découpé en intervalles, et le modèle prédisait le « token » correspondant. Simple à brancher sur un transformeur, mais cela produit des mouvements saccadés et gère mal les tâches de contact fin (saisir un objet fragile, plier du tissu).

Vidéo : comprendre les modèles VLA

Une présentation pédagogique (en anglais) des modèles Vision-Language-Action : ce qu'ils sont, leur architecture, et les travaux de référence du domaine.

Advancing Robotics with LLMs: What are Vision-Language-Action (VLA) Models

Introduction aux modèles Vision-Language-Action : « des LLMs pour les robots » expliqué simplement, l'architecture des VLA et un survol des papiers clés du domaine.

Source : YouTube, janvier 2026 (en anglais)

Cas d'usage : où les VLA commencent à agir

Robots domestiques
Manipulateurs mobiles capables de ranger une cuisine, faire la vaisselle ou plier du linge dans des maisons jamais vues — la cible explicite de π0.5, testé dans des logements réels de San Francisco.
Le foyer, marché de masse historiquement hors de portée de la robotique
Humanoïdes généralistes
Robots à forme humaine (Figure, 1X, Fourier GR-1, Unitree) pilotés par un VLA pour des tâches variées sans reprogrammation, du tri d'objets à la collaboration à deux robots.
Un seul corps polyvalent au lieu d'un robot par tâche
Manipulation industrielle
Préhension, assemblage et tri d'objets variés sur lignes de production, où le VLA généralise à de nouvelles pièces sans réingénierie de la cellule robotique.
Flexibilité sur des séries courtes et des références changeantes
Logistique et entrepôts
Dépalettisation, préparation de commandes et manipulation d'objets hétérogènes, où la généralisation à des colis jamais vus est le facteur limitant des systèmes classiques.
Automatisation de tâches de préhension longtemps réputées « non automatisables »
Tâches de contact fin
Opérations exigeant un contrôle délicat — brancher un câble, craquer une allumette, plier du tissu — rendues possibles par les trajectoires continues du flow matching et le Real-Time Chunking.
Franchit la barrière de la dextérité fine, longtemps inaccessible
Prototypage et recherche accessibles
Modèles compacts et ouverts (SmolVLA, OpenVLA, GR00T) tournant sur matériel abordable, permettant labos, écoles et makers d'expérimenter la robotique fondamentale.
Démocratisation de la R&D en robotique fondamentale
Ce que les VLA débloquent
Généralisation sémantique
Le backbone vision-langage apporte le « bon sens » d'internet : le robot peut agir sur des objets et dans des scènes jamais vus en démonstration.
Un modèle, plusieurs corps
Le cross-embodiment permet d'entraîner une politique unique meilleure sur chaque robot qu'un modèle dédié, mutualisant les données entre embodiments.
Mouvements continus et naturels
Le flow matching (π0, SmolVLA) produit des trajectoires fluides, débloquant les tâches de contact fin que les actions discrétisées ne géraient pas.
Exécution embarquée temps-réel
Modèles compacts (SmolVLA 450 M) et on-device (Gemini Robotics) tournent localement, sans réseau, éliminant la latence et tolérant la perte de connectivité.
Adaptation à peu d'exemples
Certains modèles s'adaptent à un nouveau domaine avec seulement 50 à 100 démonstrations (Gemini Robotics On-Device), réduisant fortement le coût de déploiement.
Les verrous encore profonds
Latence critique
Le temps réel reste un mur : même les VLA rapides plafonnent à 10-20 Hz sur GPU embarqué (Jetson Orin), forçant action chunking et architectures à deux vitesses.
Rareté des données
Le goulot d'étranglement n°1 : collecter des démonstrations robotiques à grande échelle est coûteux, lent et risqué. Aucune architecture ne compense un manque de données diverses.
Généralisation fragile
Hors distribution (nouveaux points de vue caméra, éclairage, objets, embodiments), les performances restent fragiles ; l'hétérogénéité des espaces d'action limite le transfert entre robots.
Sécurité et robustesse
Face à des changements imprévus de l'environnement, le comportement peut devenir non sûr — un enjeu éthique et réglementaire majeur, sans garantie formelle de sûreté à ce jour.
Coût matériel
Robots dextres, capteurs et GPU embarqués restent chers ; le robot est bien plus contraint en calcul et en énergie que l'infrastructure d'entraînement.